Spis treści
1. Hangfire był dobrym wyborem na start
Hangfire pozwolił szybko uruchomić pierwszą wersję procesu. Dostaliśmy trwałe joby, retry, harmonogramy i dashboard bez budowania własnej infrastruktury. Na etapie, gdy dopiero poznawaliśmy zachowanie integracji z Allegro, była to rozsądna decyzja.
Z czasem proces się ustabilizował. Wiedzieliśmy już, co oznacza sukces, które błędy warto ponawiać i jak bezpiecznie przetworzyć tę samą ofertę drugi raz. Wtedy mogliśmy zaprojektować kolejkę dokładnie pod ten przypadek.
2. Co zmieniła skala
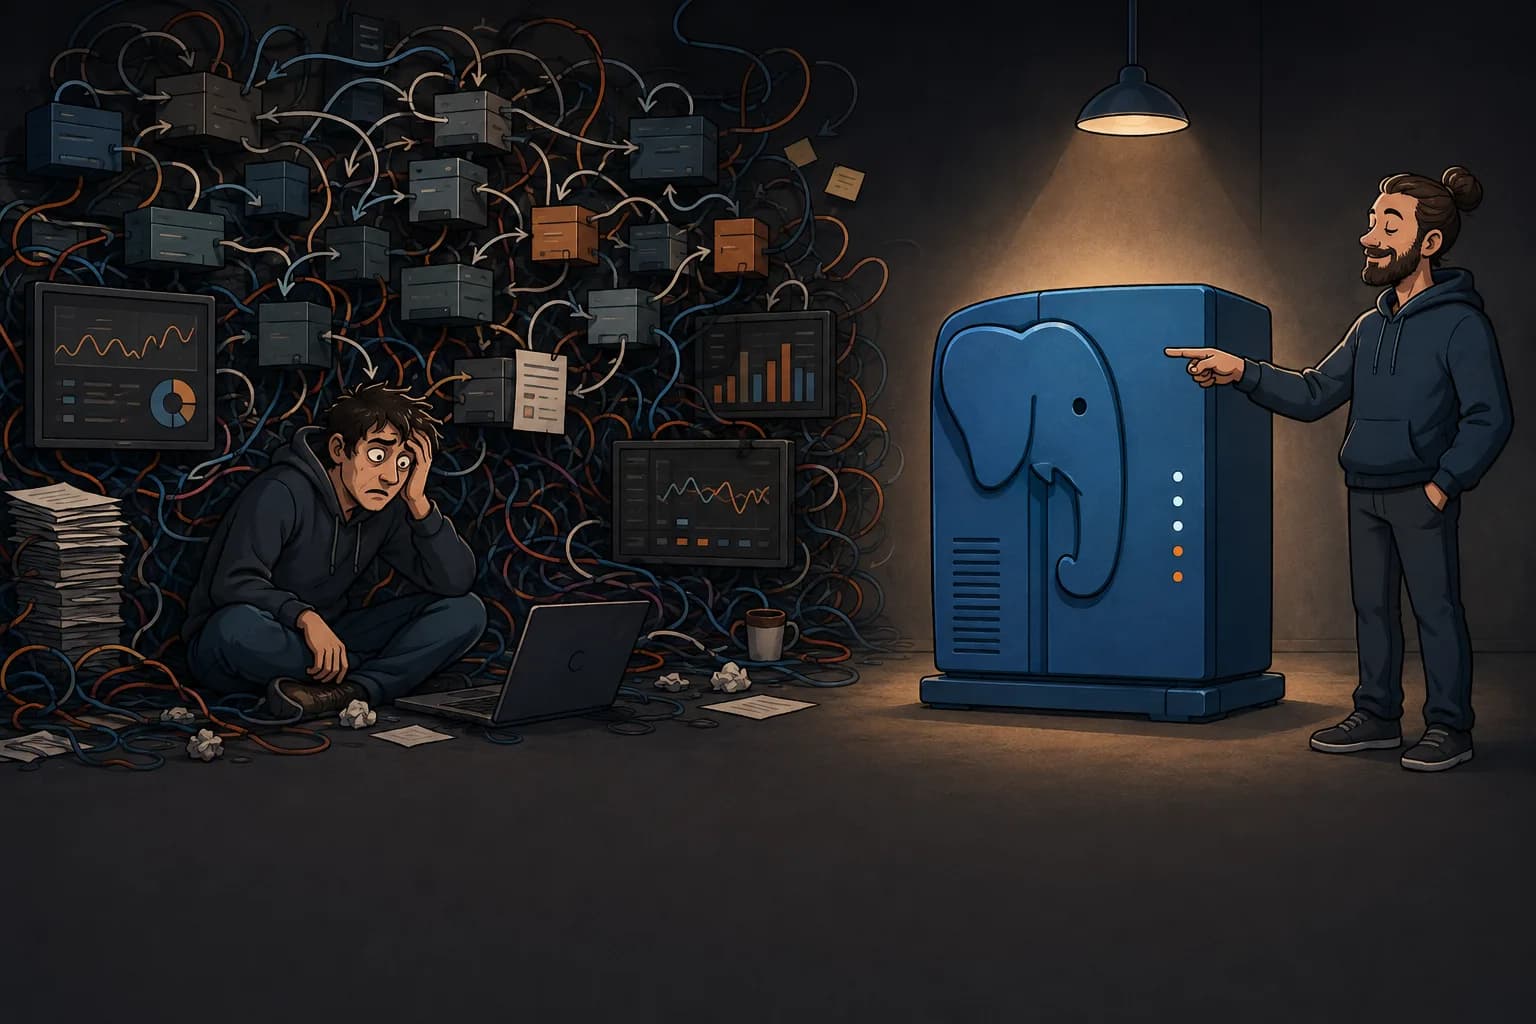
Model job per oferta generował tysiące trwałych rekordów Hangfire podczas jednej synchronizacji. Dla największego konta mówiliśmy już o około milionie ofert. Każdy job trzeba było zapisać, zaplanować i później posprzątać, zanim doszliśmy do właściwej pracy z API.
Przepustowość i tak wyznaczały limity Allegro oraz innych integracji. Milion jobów w kolejce nie pozwalał wykonać miliona requestów równolegle. Powiększał za to koszt schedulera, utrudniał operacje na kolejce i mieszał masową synchronizację z krótszymi zadaniami.
Just use Postgres
3. Dlaczego przenieśliśmy kolejkę do PostgreSQL
Po ustabilizowaniu procesu przenieśliśmy masową pracę do tabeli w PostgreSQL. Każda oferta wymagająca odświeżenia ma jeden rekord. Kolejne zdarzenie dla tej samej oferty aktualizuje istniejącą pracę, zamiast tworzyć następny job.
Hostowane serwisy .NET pobierają małe partie, wykonują integrację i zapisują wynik. Nieudana praca wraca później. PostgreSQL przechowuje stan, pozwala go połączyć z danymi biznesowymi i daje nam transakcje, backup oraz monitoring, które już mieliśmy w systemie.
Jedna oferta, jeden rekord pracy
Powtarzające się zdarzenia nie pompują kolejki.
Małe partie
Worker pobiera tylko tyle pracy, ile może teraz obsłużyć.
Stan w bazie
Backlog, retry i błędy są widoczne w zwykłych zapytaniach i metrykach.
4. Kontrola współbieżności połączeń
Liczba oczekujących rekordów nie steruje liczbą równoległych requestów. Ustawiamy osobny limit współbieżności dla połączeń z Allegro i innymi integracjami. Backlog może być duży, a aplikacja nadal wykonuje tylko tyle pracy naraz, ile bezpiecznie obsłużą zewnętrzne API i nasza infrastruktura.
PostgreSQL pilnuje też, żeby kilka procesów nie przetwarzało jednocześnie pracy dla tego samego konta. Na obecną skalę to wystarcza. Bardziej rozbudowany fair scheduling miałby sens dopiero wtedy, gdy duże konta realnie opóźniałyby pozostałe.
5. Kiedy warto zrobić podobnie
Proces jest już sprawdzony
Znasz stany, retry i warunki zakończenia.
Praca ma naturalny klucz
Możesz połączyć wiele sygnałów w jeden rekord zamiast dopisywać joby.
Zewnętrzne API ogranicza tempo
Większa kolejka nie zwiększy bezpiecznej przepustowości.
Joby są masowe i podobne
Obsługujesz dane w dużej skali, a nie tysiące różnych workflow.
Hangfire nadal dobrze obsługuje w SellersKit harmonogramy, powiadomienia i zadania uruchamiane przez operatora. PostgreSQL przejął powtarzalną pracę przy ofertach. Dziś zaczynamy od gotowego systemu jobów, mierzymy go w produkcji, a sprawdzoną pracę masową przenosimy bliżej danych, gdy skala zaczyna generować koszt.
Hangfire zaczyna ograniczać Twój system?
Pomagamy zespołom rozdzielić workflow od masowego przetwarzania danych i bezpiecznie przenieść najbardziej obciążone ścieżki do PostgreSQL.